
2 条题解
-
0
做法二(在线)
问题要求在无向图中寻找两个节点 和 v 之间所有简单路径中,第二大边权的最小值。
一条路径的第二大边权 ,等价于这条路径上最多只有一条边的权值 。
因此,我们可以将问题转化为:对于给定的阈值 ,保留图中所有权值 的边,如果 和 在同一个连通块中,或者 所在的连通块与 所在的连通块之间存在原图中的直接连边,那么存在一条满足条件的简单路径。
当路径只有一条边时,第二大边权被定义为 。这说明如果 和 之间在原图中存在直接连边,答案直接为 。
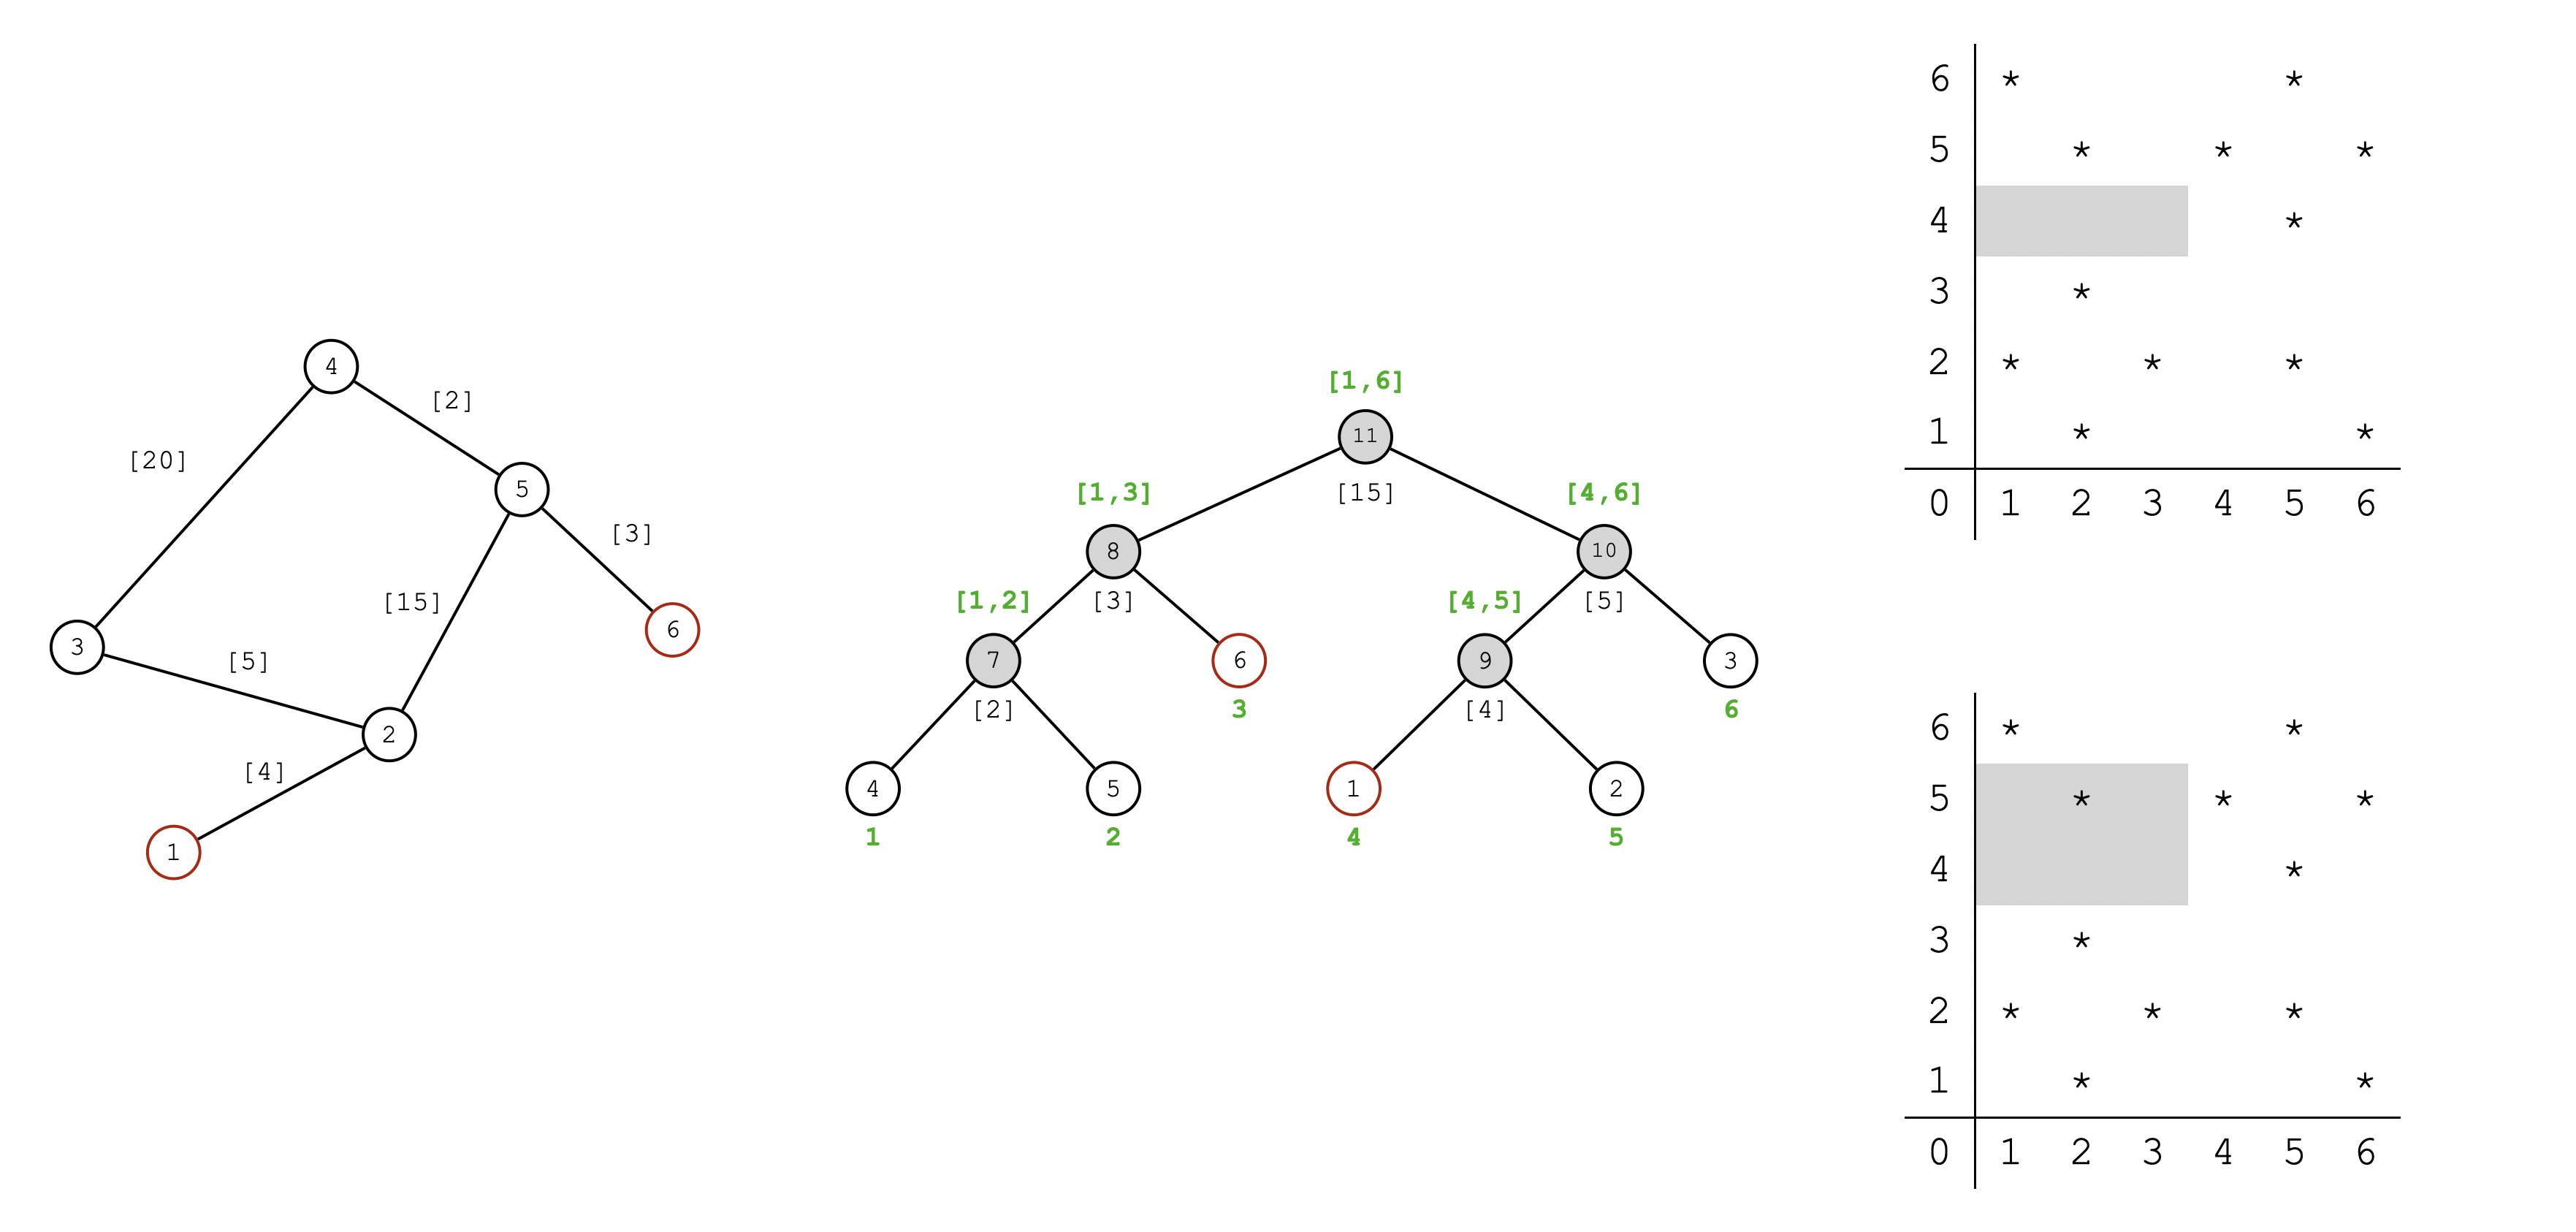
为了高效地处理 次查询,我们可以结合 Kruskal 重构树和可持久化线段树,并在此基础上对阈值 进行二分答案:
- Kruskal 重构树:将原图的所有边按权值升序排序并运行 Kruskal 算法。每次合并两个连通块时,新建一个内部节点,权值为该边的权值,并将两个连通块的根节点作为其子节点。这棵树的一个重要性质是:节点 在只经过权值 的边所能到达的所有节点,恰好构成重构树上某个祖先节点的子树,且该祖先是离根最近的权值 的节点。
- DFS 序与二维数点:重构树中,叶子节点(原图节点)的 是连续的区间。我们需要判断 所在的连通块(叶子区间 )与 所在的连通块(叶子区间 )之间是否存在原图的边。我们将原图中的每一条无向边 视为二维平面上的两个点 和 。查询跨连通块的边是否存在,就等价于查询二维平面上的矩形区域 内是否包含至少一个点。
- 可持久化线段树:用于在线、高效地回答上述的二维矩形区域求和问题。
- 二分答案:对于每组查询,先判断是否不连通(输出 )或存在直接连边(输出 )。否则,在最小生成树的所有边权中二分查找最小的满足条件的 。
使用之前的例子模拟过程:
#include <cstdio> #include <vector> #include <algorithm> using namespace std; #define N 100005 #define M 200005 struct E { int u, v, w; bool operator<(const E &other) const { return w < other.w; } } e[M]; int n, m, q; vector<pair<int, int>> st; // 边集合, 判断询问的两点之间是否直接有边相连 vector<int> w; // 边权集合, 用于二分答案 // DSU int fa[N << 1]; int get(int x) { while (x != fa[x]) x = fa[x] = fa[fa[x]]; return x; } // Kruskal Reconstruction Tree int val[N << 1]; vector<int> krt[N << 1], pt[N]; int f[N << 1][20], dfn[N << 1], dep[N << 1], lg[N << 1]; int L[N << 1], R[N << 1]; void build() { static int idx = n; for (int i = 1; i < n * 2; i++) fa[i] = i; sort(e, e + m); for (int i = 0; i < m; i++) { int u = get(e[i].u); int v = get(e[i].v); if (u != v) { fa[u] = fa[v] = ++idx; val[idx] = e[i].w; krt[idx].push_back(u); krt[idx].push_back(v); } } for (int i = 1; i <= idx; i++) lg[i] = lg[i >> 1] + 1; } void dfs(int u, int p) { static int idx = 0; f[u][0] = p; dep[u] = dep[p] + 1; for (int i = 1; i <= lg[dep[u]]; i++) { f[u][i] = f[f[u][i - 1]][i - 1]; } if (u <= n) { L[u] = R[u] = dfn[u] = ++idx; } else { L[u] = 1e9; R[u] = -1e9; for (int v : krt[u]) { dfs(v, u); L[u] = min(L[u], L[v]); R[u] = max(R[u], R[v]); } } } // Persistent Segment Tree struct T { int lc, rc, sum; } tr[N << 7]; int rt[N]; int insert(int x, int l, int r, int p) { static int idx = 0; int q = ++idx; tr[q] = tr[p]; tr[q].sum++; if (l == r) return q; int mid = (l + r) >> 1; if (x <= mid) { tr[q].lc = insert(x, l, mid, tr[p].lc); } else { tr[q].rc = insert(x, mid + 1, r, tr[p].rc); } return q; } int query(int ql, int qr, int l, int r, int p) { if (!p || ql > r || qr < l) return 0; if (ql <= l && r <= qr) return tr[p].sum; int mid = (l + r) >> 1; return query(ql, qr, l, mid, tr[p].lc) + query(ql, qr, mid + 1, r, tr[p].rc); } int cnt(int x1, int x2, int y1, int y2) { return query(y1, y2, 1, n, rt[x2]) - query(y1, y2, 1, n, rt[x1 - 1]); } // 判断 u 和 v 之间是否直接有边相连 int check(int u, int v) { if (u > v) swap(u, v); auto it = lower_bound(st.begin(), st.end(), make_pair(u, v)); return it != st.end() && *it == make_pair(u, v); } // 树上倍增求 u 的权值小于等于 x 的最高祖先 // 说明在这个连通块内部所有的边权都不超过 x int getf(int u, int x) { for (int i = lg[dep[u]]; i >= 0; i--) { if (f[u][i] && val[f[u][i]] <= x) { u = f[u][i]; } } return u; } int main() { scanf("%d %d %d", &n, &m, &q); for (int i = 0; i < m; i++) { scanf("%d %d %d", &e[i].u, &e[i].v, &e[i].w); if (e[i].u > e[i].v) swap(e[i].u, e[i].v); st.push_back({e[i].u, e[i].v}); w.push_back(e[i].w); } sort(w.begin(), w.end()); w.erase(unique(w.begin(), w.end()), w.end()); sort(st.begin(), st.end()); st.erase(unique(st.begin(), st.end()), st.end()); // krt 建树及预处理 build(); for (int i = 1; i < n * 2; i++) { if (fa[i] == i) dfs(i, 0); } // 将原图中的边转化为二维平面上的点 for (auto &edge : st) { int x = dfn[edge.first]; int y = dfn[edge.second]; pt[x].push_back(y); pt[y].push_back(x); } for (int x = 1; x <= n; x++) { rt[x] = rt[x - 1]; for (int y : pt[x]) { rt[x] = insert(y, 1, n, rt[x]); } } // 处理查询 for (int i = 1, u, v; i <= q; i++) { scanf("%d %d", &u, &v); if (get(u) != get(v)) { printf("-1\n"); continue; } if (check(u, v)) { printf("0\n"); continue; } int l = 0, r = w.size() - 1, ans = -1; while (l <= r) { int mid = (l + r) >> 1; int fu = getf(u, w[mid]); int fv = getf(v, w[mid]); if (fu == fv || cnt(L[fu], R[fu], L[fv], R[fv])) { ans = w[mid]; r = mid - 1; } else { l = mid + 1; } } printf("%d\n", ans); } return 0; } -
0
做法一(离线)
由于我们要找的是最小的 ,我们不妨按照边权从小到大排序(类似 算法),逐条加边。当我们正在处理权值为 的边时,图中已经连通的块内部只包含权值 的边。
对于某个查询 ,它在何时会第一次满足条件?
- 直接连通: 和 原本在不同的连通块,因为加入这条边,它们合并到了同一个连通块中。此时路径上最大边就是 ,且 就是最大边权的最小值。
- 跨越一条原图的边: 所在的连通块 和 所在的连通块 虽然还没有被 的边合并,但原图中存在一条边直接连接了 和 。此时,我们可以用 的边在 和 内部走,中间跨越那条大于 的原图边,这条路径的第二大边必定 。
因此,我们要维护的是连通块之间的相邻关系和查询关系。
对于每一个连通块(用并查集的根节点代表),我们维护两个集合:
- 相邻点集 :与连通块 有原图边相连的其他连通块的根节点。
- 查询集 :所有一端在连通块 内部,另一端在其他连通块的查询(记录目标连通块的根节点和查询编号)。
当我们加入一条权值为 的边,使得连通块 和连通块 需要合并时。为了保证时间复杂度,我们比较 和 的大小,将较小的集合合并到较大的集合中(假设 较小,合并到 )。
在合并的同时,我们要检查是否有查询因为这次合并而被满足(即上述的“只需要再加一条边就可以连通”):
- 遍历 中的每一个相邻连通块 :如果 与 之间本来就存在查询(即 ),说明 和 合并后, 带来的相邻块 刚好满足了 的某个查询,该查询的答案就是 。
- 遍历 中的每一个查询(假设目标连通块为 ):如果 ,说明查询的两端合二为一,答案是 。如果 ,说明 带来的查询目标 ,刚好是 的相邻块,两端通过 原有的邻居连通,答案是 。
处理完这些满足的查询后,将 暴力插入 ,将 暴力插入 ,并在全局更新这些关系,删除已经得出答案的查询。根据启发式合并的性质,每个元素最多被移动 次,配合
std::set的操作,整体时间复杂度为 。参考代码:
#include <cstdio>
#include <vector>
#include <algorithm>
#include <set>
using namespace std;

#define MAXN 100005
#define MAXM 200005

struct E {
    int u, v, w;
    bool operator<(const E &other) const {
        return w < other.w;
    }
} e[MAXM];

int n, m, q;
// 记录原始边,用于处理初始只用一条边连通的情况
set<pair<int, int>> st;

// 并查集
int fa[MAXN];

int get(int x) {
    while (x != fa[x]) x = fa[x] = fa[fa[x]];
    return x;
}

set<int> N[MAXN];            // N[u]: 与连通块 u 相邻的连通块根节点
set<pair<int, int>> Q[MAXN]; // Q[u]: <目标连通块根节点, 查询编号>

int ans[MAXN];
int pos1[MAXN], pos2[MAXN]; // 追踪每个查询当前所在的两个连通块

int main() {
    scanf("%d %d %d", &n, &m, &q);
    for (int i = 1, u, v, w; i <= m; i++) {
        scanf("%d %d %d", &e[i].u, &e[i].v, &e[i].w);
        if (e[i].u > e[i].v) swap(e[i].u, e[i].v);
        st.insert({e[i].u, e[i].v});
    }
    for (int i = 1; i <= n; i++) fa[i] = i;
    for (int i = 1, u, v; i <= q; i++) {
        scanf("%d %d", &u, &v);
        if (u > v) swap(u, v);
        // 如果查询的两个点之间本来就有直接连边,答案为 0
        if (st.count({u, v})) {
            ans[i] = 0;
        } else {
            ans[i] = -1;
            Q[u].insert({v, i});
            Q[v].insert({u, i});
            pos1[i] = u;
            pos2[i] = v;
        }
    }
    // 初始化相邻关系
    for (int i = 1; i <= m; i++) {
        if (e[i].u != e[i].v) {
            N[e[i].u].insert(e[i].v);
            N[e[i].v].insert(e[i].u);
        }
    }
    sort(e + 1, e + m + 1);
    for (int i = 1; i <= m; i++) {
        int u = get(e[i].u);
        int v = get(e[i].v);
        int w = e[i].w;
        if (u == v) continue;
        // 启发式合并:保证 u 是较小的集合
        if (N[u].size() + Q[u].size() > N[v].size() + Q[v].size()) {
            swap(u, v);
        }
        // 将 u 合并到 v
        fa[u] = v;
        vector<int> solved;
        // 遍历 N(u),看 u 的邻居是否与 v 有查询
        for (int x : N[u]) {
            if (x == v) continue;
            auto it = Q[v].lower_bound({x, 0});
            while (it != Q[v].end() && it->first == x) {
                if (ans[it->second] == -1) {
                    ans[it->second] = w;
                    solved.push_back(it->second);
                }
                it++;
            }
        }
        // 遍历 Q(u),看 u 的查询目标是否在 N(v) 中,或者就是 v 本身
        for (auto x : Q[u]) {
            int tar = x.first;
            int id = x.second;
            if (ans[id] != -1) continue;
            if (tar == v || N[v].count(tar)) {
                ans[id] = w;
                solved.push_back(id);
            }
        }
        // 将 N[u] 的元素迁移到 N[v],并更新对方的指向
        for (int x : N[u]) {
            if (x == v) continue;
            N[x].erase(u);
            N[x].insert(v);
            N[v].insert(x);
        }
        N[v].erase(u);
        N[v].erase(v);
        // 将 Q[u] 的查询迁移到 Q[v],并更新追踪位置
        for (auto x : Q[u]) {
            int tar = x.first;
            int id = x.second;
            if (ans[id] != -1) continue; // 已经被满足的查询直接丢弃
            Q[tar].erase({u, id});
            if (tar != v) {
                Q[tar].insert({v, id});
                Q[v].insert({tar, id});
                if (pos1[id] == u) {
                    pos1[id] = v;
                } else if (pos2[id] == u) {
                    pos2[id] = v;
                }
            }
        }
        // 清理被满足的查询,避免无效遍历增加常数
        for (int id : solved) {
            int c1 = pos1[id];
            int c2 = pos2[id];
            Q[c1].erase({c2, id});
            Q[c2].erase({c1, id});
        }
    }
    for (int i = 1; i <= q; i++) {
        printf("%d\n", ans[i]);
    }
    return 0;
}
 Sam
LV 1
SU
@ 2026-9-11 9:55:35
- 1